多模型编排取代模型忠诚:2026 AI视频工具怎么选才不踩坑?
别再当“模型忠诚用户”了,2026年没人这么玩
上个月,一位做企业培训的朋友跟我吐槽:他花大价钱订阅了某款号称“最强”的AI视频工具,结果做产品演示视频时,画面里的产品渲染得不错,但配音生硬得像机器人,字幕还经常对不上口型。
他问我:“是不是我用的姿势不对?”
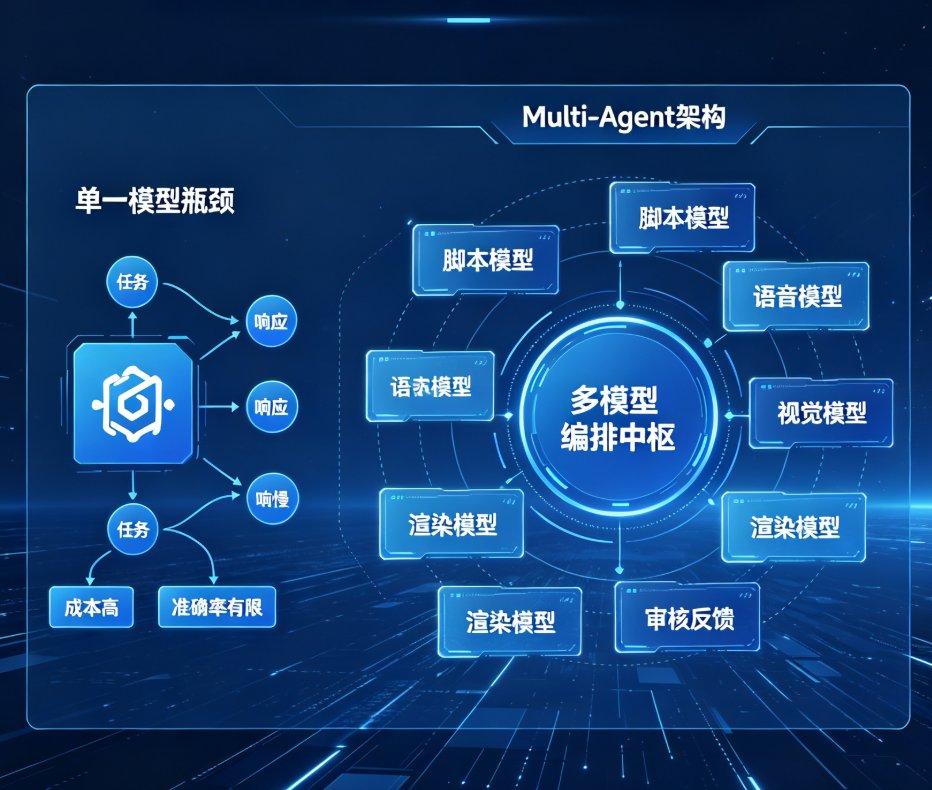
说句实在话,不是你的问题,是工具选错了。2026年的AI视频领域,已经不存在“一个模型打天下”这回事了。 头部模型各有所长,但没有任何一个能在所有场景做到最佳。
Pixo的实测横评里说得很直白:专业团队至少同时用三个模型——Kling处理动作密集场景、Happy Horse做对话内容、Veo拍主角镜头、Grok做快速剪辑。 试图用单一模型完成所有任务,就像用瑞士军刀盖房子——理论上可行,实际操作中低效得让人抓狂。
01 为什么“模型忠诚”在2026年彻底失效了?
先看一组来自Elser.ai的2026年AI视频模型横评结论:
| 场景 | 最佳模型 | 核心优势 |
|---|---|---|
| 高端品牌营销 | Veo 3.1 | 4K输出、照片级真实感 |
| 音频驱动对话 | HappyHorse-1.0 | 唇音同步、多语言支持 |
| 快速迭代编辑 | Grok Imagine 1.0 | 零门槛修改、描述式编辑 |
| 开发者技术流 | Wan 2.7 | 开源权重、逐帧精准控制 |
每个模型都有自己的“主场”,但没有一个能通吃所有场景。 这就是多模型编排兴起的根本原因。
再想想你的实际需求:做一条知识播讲视频,你需要配音自然、字幕同步、画面清晰;做企业宣传片,你需要风格统一、节奏明快、品牌元素突出;做新闻播报,你需要虚拟主播形象定制、背景板可换、字幕样式灵活。
这些需求,靠单一模型能全部满足吗?
说白了,2026年的AI视频制作,已经从“选哪个模型”变成了“在哪里能跑多个模型而不用付四份订阅费”。 多模型编排不是锦上添花,而是刚需。
02 多模型编排到底怎么“编”?一个真实案例讲透
咱们拿企业培训视频来举例。假设你要把一份50页的PPT课件变成一节10分钟的播讲课程。
传统做法是:先找个文生视频工具生成画面,再找个配音工具配音,然后手动把字幕加上去,最后还要调整节奏。每个环节用不同工具,素材格式不兼容,光转换格式就能耗掉半天。
多模型编排的做法是:你只需要描述需求,一个Agent自动拆解任务——哪些页面需要动画演示、哪些知识点需要虚拟讲师出镜、配音用什么语言和音色、字幕怎么排版——然后为每个环节调度最合适的AI模块。
燃点魔方的视频Agent就是这么干的。你输入“把这份课件变成课程视频,用虚拟讲师+图文演示,配中英双语字幕”,它会自动完成分镜设计、素材匹配、配音合成、字幕生成,最后渲染出一条可发布的视频。
整个过程不需要你手动切换任何工具,也不需要你懂技术。 这就是多模型编排的核心价值:把选择权交给系统,把精力留给内容。
偷偷告诉你:燃点魔方在知识播讲场景里,会自动把配音、字幕、虚拟讲师三个模块分开调度,而不是用一个模型硬扛所有任务。 所以你能明显感觉到,配音更自然、字幕更精准、讲师形象更稳定。
03 燃点魔方如何实现“场景化最优”?
说句实在话,多模型编排听起来很美好,但实现起来有个大坑:如果只是把多个模型堆在一起,没有统一的调度逻辑,那跟你自己手动切换工具没什么区别。
真正的多模型编排,需要三个能力:
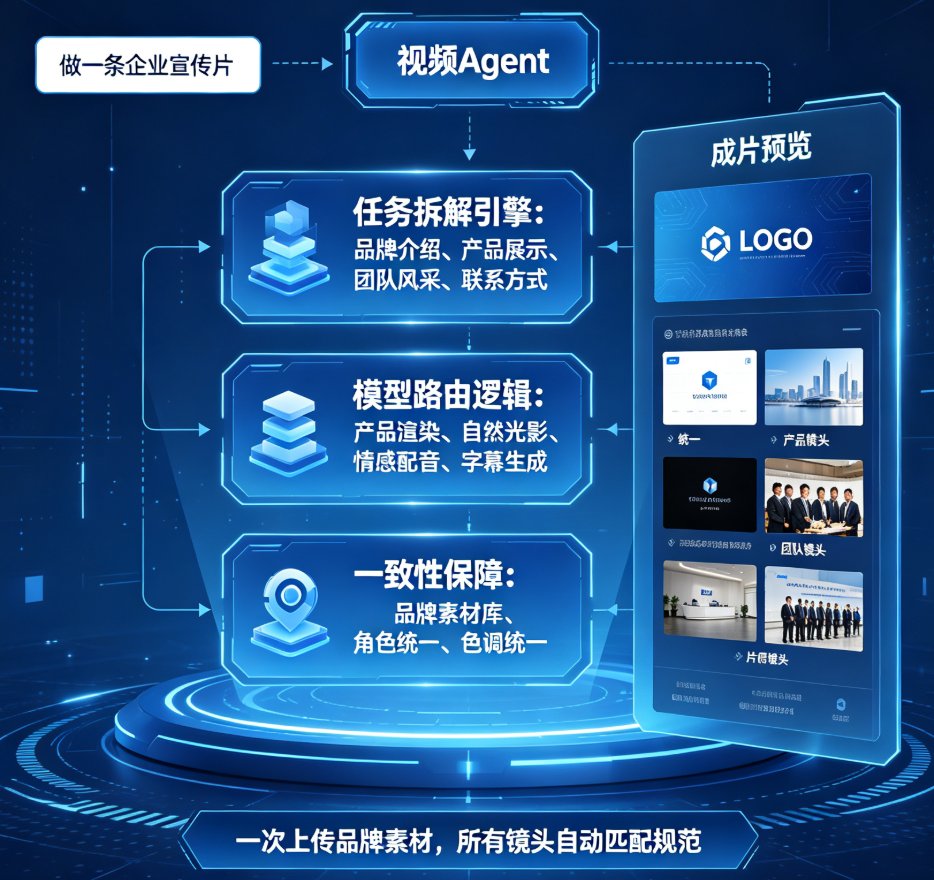
第一,任务拆解能力。 Agent能把你的模糊需求拆成具体的子任务。你说“做一条企业宣传片”,它得知道要拆成品牌介绍、产品展示、团队风采、联系方式这几个模块,每个模块用不同的表现手法。
第二,模型路由能力。 每个子任务分配给最合适的模型。比如产品展示用渲染精度高的模型,团队风采用自然光影好的模型,配音用情感表达丰富的TTS模型。
第三,一致性保障能力。 多个模型产出的素材,风格、色调、角色形象必须统一。否则就会出现“前面是写实风,后面突然变卡通”的尴尬。
燃点魔方在这三方面都有对应的设计。它的视频Agent内置了任务拆解引擎和模型路由逻辑,同时通过品牌素材库和角色一致性模块,确保多模型协作时风格统一。 你上传一次Logo和产品图,之后所有镜头都会自动匹配品牌视觉规范。
别踩这个坑:市面上有些所谓“多模型平台”,其实只是把多个模型的提示词框放在一个页面上,模型之间没有任何协同。 你选A模型生成画面,再选B模型生成配音,最后还得自己拼。这不是多模型编排,这是多工具拼盘。
04 多模型编排 vs 单一模型:数据不会骗人
为了让你更直观地理解差距,我整理了一张对比表:
| 维度 | 单一模型方案 | 多模型编排方案 |
|---|---|---|
| 场景覆盖 | 只能覆盖模型擅长的场景 | 每个场景都用最合适的模型 |
| 制作效率 | 需手动切换多个工具 | Agent自动调度,一键成片 |
| 素材一致性 | 跨工具素材难兼容 | 共享素材库,角色产品统一 |
| 修改迭代 | 改一处可能影响全局 | 支持局部重做,不影响其他模块 |
| 成本控制 | 多份订阅费叠加 | 一份订阅覆盖多个模型 |
| 上手门槛 | 需要学习多个界面 | 对话式指令,零基础可用 |
多模型编排不是“更高级”的选项,而是“更务实”的选择。 尤其对教师、培训师、企业市场人员这些非技术背景的用户来说,与其花时间研究哪个模型适合哪个场景,不如让Agent帮你做决策。
这里有一个SVG图表,直观展示多模型编排在不同场景下的优势:
注:数据基于Pixo和Elser.ai的横评结论整理,反映不同方案在典型场景下的综合表现。
05 选型建议:2026年你该怎么选AI视频工具?
如果你正在纠结“该选哪个AI视频工具”,我给你三条实在的建议:
第一,先看工作流,再看模型。 别被“最强模型”的宣传带偏。你的需求是“做出一条成片”,不是“生成一个片段”。能让你从需求到成片一气呵成的工具,才是好工具。
第二,多模型编排是趋势,但要看实现方式。 真正有价值的编排,是Agent帮你做决策,而不是把选择权抛回给你。燃点魔方的视频Agent能自动拆解任务、调度最优模块,这才是多模型编排的正确打开方式。
第三,别忽视一致性。 多模型协作最大的风险是风格不统一。选工具时,重点看它有没有角色一致性方案、品牌素材库这类保障机制。
说白了,2026年选AI视频工具,选的不是模型,而是“调度能力”。 谁能帮你把多个模型的优势组合起来,谁就能让你用最少的精力做出最好的视频。
如果你想深入了解多模型编排的具体实现,可以看看这篇关于AI视频多模型编排趋势的分析,里面讲了如何避免被单一模型锁死。另外,AI视频Agent vs 传统生成器的对比也值得一读。
06 总结:从“模型忠诚”到“结果导向”
2026年的AI视频领域,最明显的趋势就是多模型编排取代模型忠诚。创作者不再执着于“哪个模型最强”,而是更关心“如何用最少的成本获得最好的结果”。
燃点魔方做的,就是把这种编排能力产品化——让没有技术背景的教师、培训师、市场人员,也能享受多模型协作带来的质量红利。 你不需要知道背后调用了哪个模型,只需要描述需求,剩下的交给Agent。
说句实在话,这才是AI工具该有的样子:让技术回归后台,让创作回归内容。
常见问题
什么是多模型编排?为什么2026年它取代了模型忠诚?
多模型编排是指在一个视频制作流程中,根据每个环节的需求自动调用不同的AI模型或模块,而不是从头到尾只用同一个模型。2026年头部AI视频模型在真实感、唇音同步、运动控制等维度互有胜负,单一模型无法在所有场景做到最佳。实测显示,专业团队至少使用三种模型:Kling处理动作密集场景、Happy Horse做对话内容、Veo拍主角镜头。多模型编排让每个镜头都交给最擅长的模型,整体质量远超单模型方案。
多模型编排和传统AI视频生成器有什么区别?
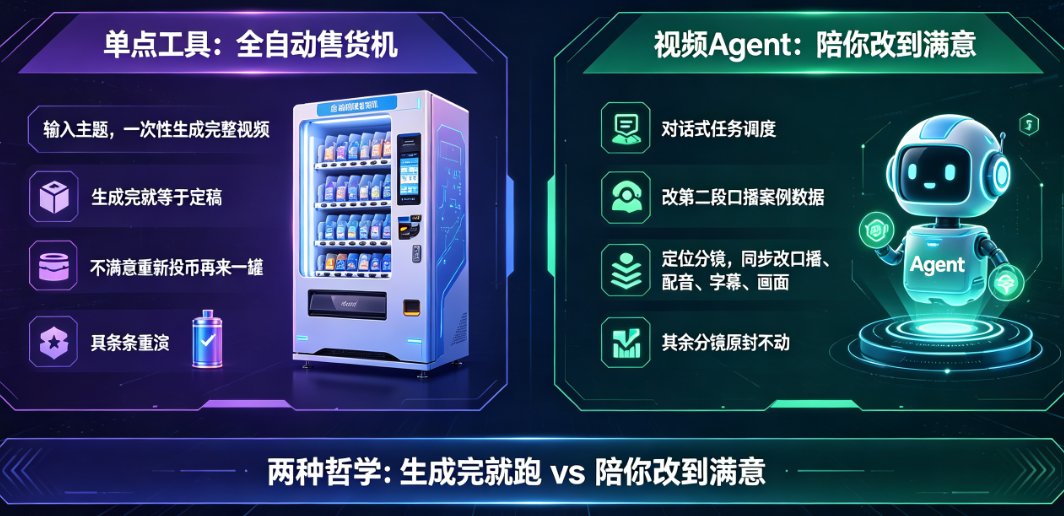
传统生成器是“一个模型走天下”,你输入提示词,它输出片段,换模型就得换工具、换订阅、换界面,素材还搬不动。多模型编排则像制片流水线:一个Agent把你的需求拆解成镜头,给每个镜头分配最合适的模型,并通过共享素材库保持角色和产品一致。你得到的是一支成片,而不是一堆需要自己拼的片段。
燃点魔方如何实现多模型编排?
燃点魔方通过视频Agent实现多模型编排。你只需用对话式指令描述需求,Agent会自动拆解任务、生成分镜,然后根据每个环节的特点调度最合适的AI模块——比如用A模型做配音、B模型做字幕、C模型做渲染。整个过程无需手动切换工具,多轮修改和局部重做也由Agent统一协调。
多模型编排对普通创作者有什么实际价值?
最大的价值是省心。你不需要同时订阅四五个工具、学习不同界面、管理API密钥,也不用担心素材在工具之间搬不动。燃点魔方把多模型能力整合在一个平台里,你只需要描述需求,剩下的调度交给Agent。对教师、培训师、企业市场人员来说,这意味着不用成为技术专家,也能用上顶级AI能力。
如何开始使用多模型编排?
先从你的高频场景入手。如果你经常做知识播讲视频,可以用燃点魔方的知识播讲功能,它会自动调度配音、字幕、虚拟讲师等模块;如果你做企业宣传片,可以用企业宣传视频模板,上传Logo和产品图后自动生成统一风格。关键是别一上来就追求所有模型,先让Agent帮你跑通一个完整流程。